处在Agentic 工程的什么位置? 我将其放在loop往后一点的位置,因为loop agent可以是graph 里面的一个节点或者一个部分。但我并不觉得它在loop后面一大层,它只是从任务角度进行的视角上移. 因为loop里面也可以走graph, 以后造词可能会出现 graphloopgraphloopgraph…
prompt->context->harness->loop engineer ->graph engineer
解决loop存在的缺陷?
- 单个智能体长周期运行,看不到自己的错误,导致错误的累积
- loop一直运行,产生巨量上下文,导致上下文溢出爆炸。带来模型降智、目标被淹没在上下文中导致偏移问题。
- 缺乏控制颗粒度,暂停、调整、改变方向比较困难,可控性较弱。甚至终止循环可能要么全有要么全无、在中间添加质检等。
- 可解释、可观测性差。要面对海量上下文,并且并不知道为什么模型会篇。
设计核心哲学: 观点1: 避免让一种身份设定、一个视角的推进、干完全部的活。本质是一种Agent上下文治理哲学,让各个层级关注好各个层级之间的必要信息即可。例如,顶层智能体接到调研任务委派子智能体,子智能体只汇报结果,就避免了顶层智能体的上下文被调研过程的上下文污染了。
观点2: how you design a policy, so the whole thing stops living inside one messy, giant session. A managed workflow with agent in it
什么时候适合用Graph ?
- 单步无法完成
- 数据、信息有多个来源
- 并行性存在必要.
- 产出需要被评估/产出结果影响严重(严肃任务)
- 人类控制权限\边界\产出等
Graph在这里的定义(V,E,S,P):
- 节点: 干活的执行单元(我可以将其理解为一个特定身份的Agent或者一个段单元测试代码)
- 边:节点之间的流转,定义节点到节点的方向。
- 状态: shared state. 节点之间的共同信息、共写的对象与上下文等
- 策略: 约束规范,谁可以创建节点,谁可以进行决策等.
**行业常用三种结构模式(策略)**可以自由组合:
- 菱形fan-in/fan-out: 主智能体张成子智能体委派任务,然后再汇报收敛
- 管理+worker: 主智能体调度子智能体工作,进行任务委派、验收、反馈等,像是智能/上下文过滤器
- pipline: 能够被干净的拆解成子步骤的任务场景。中间步骤与步骤之间,可以加入验证节点。
智能体系统翻车/不及预期的原因: 某种情况的出现,让智能体进入到自己的幻觉中空转。既逐步自己相信自己,既规划又实现,又打分判断。
注意事项:
- 先用最简单的东西,而不是上来就添加各种兜底与复杂设计,等到简单的实现无法应对对应的功能的时候,再优化添加功能。(实现优先,避免overengineering, 过多的Agent只会产生更多的幻觉,产生更平庸的结果)
- 让模型的智力落到节点上。让代码的真实验证落到边上。即避免过度使用模型的智力,让整个agent系统变成了模型幻觉的空转。必须有向现实情况,进行真实的验证。
- 创建你懂每一步发生了什么的自动化. 而不是直接开始自动化,这只会创建噪音
实现GraphEngineering的层级:
- 动脑思考这个任务的图应该画成什么样,先画出来,手动实现测试这个流程
- 落地成Agent的skill流程。自动化。
- 进入固定的框架(langraph、AutoGen、自研脚本、n8n)各自解决各自场景下的问题.
我的思考:
- Graph与Loop engineering都是对于复杂任务的设计,是一种应对特定情况的工具,不是AGI。所有的工程设计,都必须服务于现实需求,必须避免一上来就使用重的工具来大炮打蚊子
- 对于同一个任务,另一个同级别视角(现实代码验证、其他Agent、其他LLM信息源)的出现是绝对会有帮助的。无论是从提供更多信息的角度,还是从验证干活质量的角度而言。
- 这一轮Graph engineering的核心理念依然是围绕智能体循环中的任务可靠、可接入、可解释等目的进行实现的,为的是生成流程的稳定、可复现不出错,是对幻觉的厌恶与确定性的追求。依然是将模型的创造力,放入到对应的边界中.
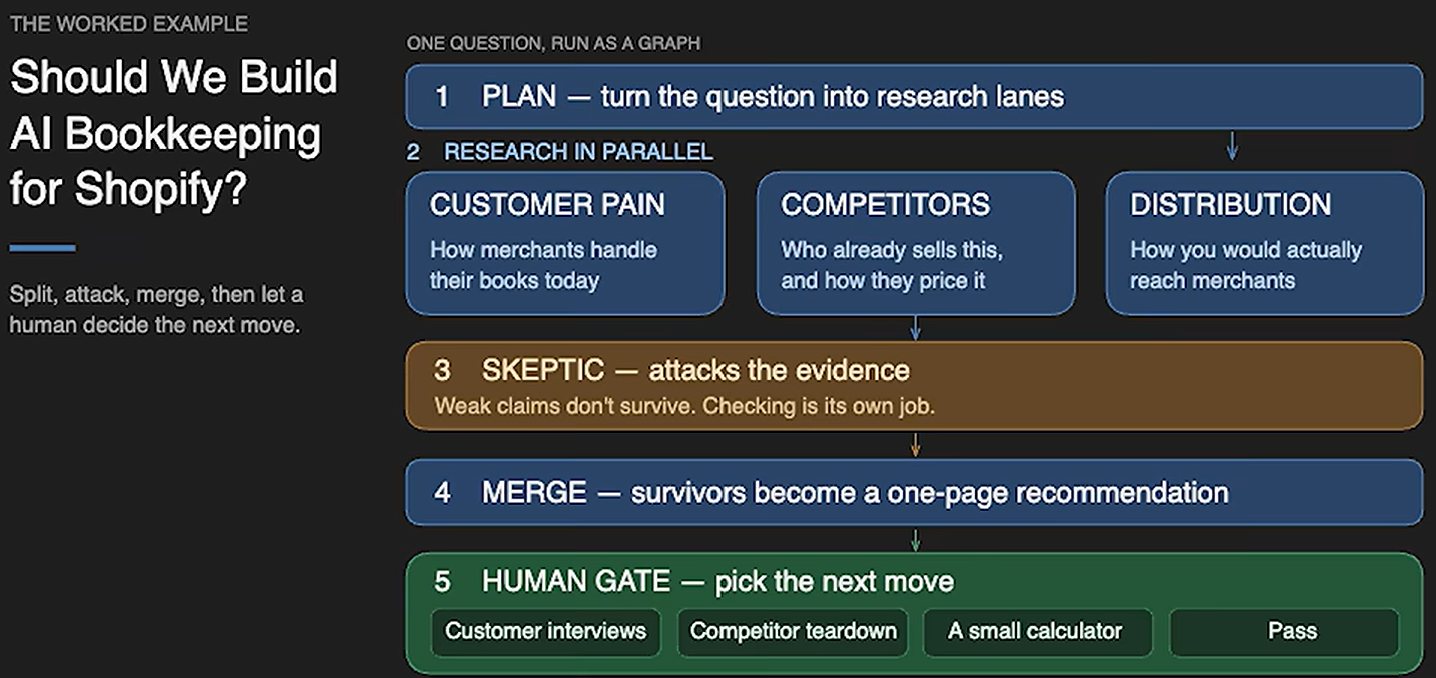
信息来源: Why Graph Engineering will 10x your Claude/Codex - YouTube 什么是图工程 | Graph Engineering | 循环工程 | Loop Engineering | 多智能体 | LangGraph | ReAct | 提示词工程 | 工作流编排 |验证器 - YouTube